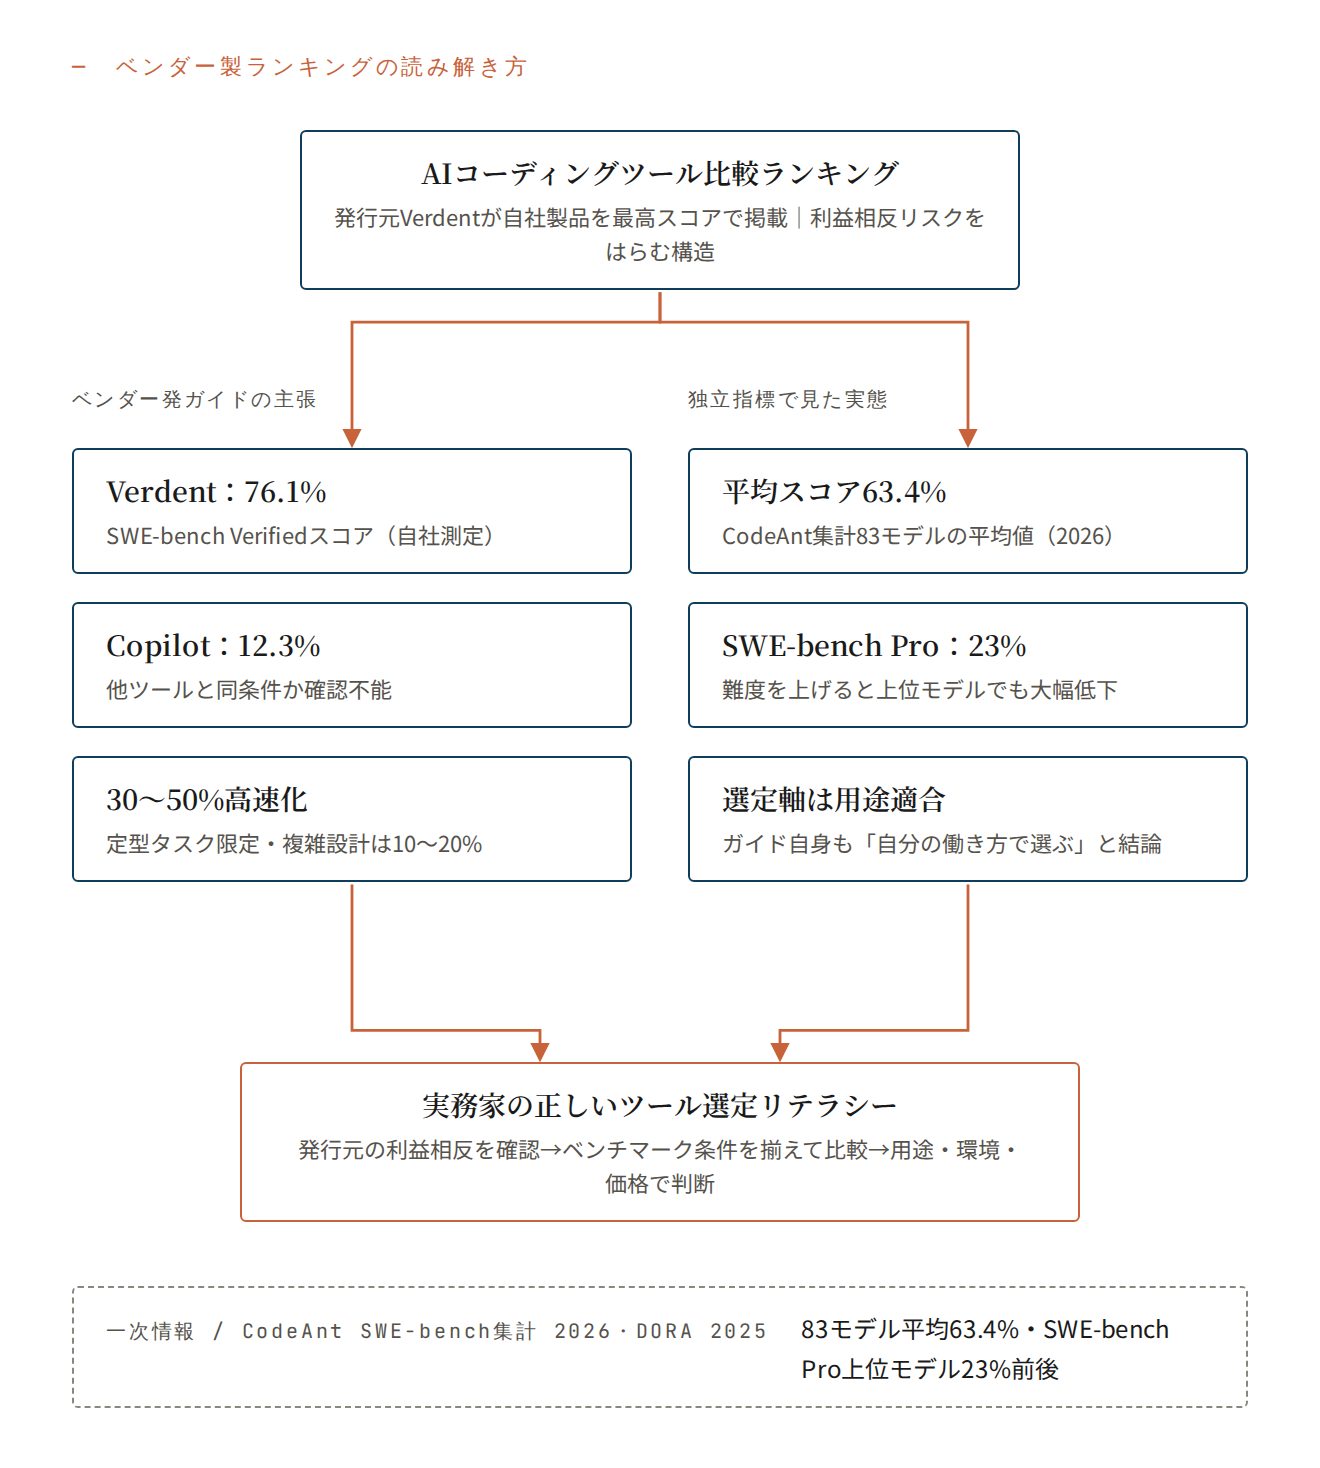
AIコーディングエージェント開発企業のVerdentが、「Best AI Coding Assistants 2026」と題した比較ガイドを公開し、GitHub Copilot、Claude Code、Cursorなど主要10ツールを6週間かけてテストした結果をランキング形式で示しました。同ガイドは「どのツールが最良かではなく、自分の働き方に合うかで選ぶべきだ」と結論づけています。一見中立的な比較記事ですが、発行元自身が自社製品を最高スコアで登場させるという構図があり、読み方には注意が必要です。税理士業界でもAIによる業務自動化やスクリプト作成が広がりつつある今、この種の「ベンダー製ランキング」をどう読むかは、私たち実務家のツール選定リテラシーそのものだと考えられます。
背景と全体像
AIコーディング支援ツールは、この2〜3年で開発現場の標準装備になりました。Stack Overflowの2025年開発者調査は、AIツールを利用中または利用予定の開発者が84%(前年76%)に達したことを示しています。また、Google Cloudが公表したDORA「State of AI-assisted Software Development 2025」レポートは、開発者の90%が日常的にAIを使っていると報告しています。
ツールの性能を測る共通指標として広く使われているのが「SWE-bench Verified」です。DemandSphereの解説によれば、これは実際のGitHub上の課題500件をAIに修正させ、既存テストを壊さずにバグを直せた割合を測るベンチマークです。CodeAntの2026年集計では、評価対象83モデルの平均スコアは63.4%、上位モデルは80%超に達していると報告されています。一方で、同集計はより難度の高い「SWE-bench Pro」では最上位モデルでも23%前後にとどまることも示しており、ベンチマークの種類と条件によって数字の印象が大きく変わる点は押さえておくべきでしょう。
詳細解説
Verdentのガイドは、同社のプリンシパルエンジニアが10以上のツールを6週間テストしたとし、用途別の推奨を示しています。同ガイドの整理では、GitHub Copilot(月額10〜19ドル)は日常的なコーディングの信頼性で最有力、Claude Codeはターミナル中心のワークフロー向け、Cursor(月額20ドル)はAIネイティブなエディタ体験、Tabnine(月額12〜39ドル)はオンプレミス対応とSOC 2 Type II認証を備えたプライバシー重視の環境向け、Amazon Q Developer(月額19ドル)はAWS環境向け、と位置づけられています。
注目すべきは、同ガイドが各ツールにSWE-bench Verifiedスコアを併記し、GitHub Copilotを12.3%とする一方、自社のVerdentには76.1%という際立った数字を与えている点です。この76.1%という数字自体は、Verdent自身の技術レポートが「単回試行(pass@1)で76.1%、3回試行(pass@3)で81.2%を達成した」と公表しているもので、Testing Catalogの報道でも取り上げられています。同社の説明によれば、VerdentはClaude Sonnet 4.5やGPT系など複数の上位モデルを「計画→実装→検証」のループで並列に動かすエージェント型ツールで、料金は月額19ドルから179ドルです。
生産性への効果について、同ガイドは「定型的なタスクで30〜50%の高速化、複雑な設計作業では10〜20%の改善にとどまる」とし、「AIはコード品質やセキュリティの判断を代替しない」と明記しています。この結論部分は、後述する独立系の研究とも方向性が一致しており、比較的誠実な記述だと私は見ています。
論点と異なる見方
第一の論点は、利益相反です。このランキングは第三者機関ではなくVerdent自身が発行しており、自社製品が最高スコアで掲載されています。また、併記されたベンチマーク数字は測定時期や実行条件が揃っているとは確認できず、前述のCodeAnt集計が示す「83モデル平均63.4%」という水準と比べると、Copilotの12.3%という数字は他ツールと同条件で測ったものか疑問が残ります。私は、この種の記事は「ツール一覧と選定観点の整理」としては有用でも、スコアの序列をそのまま信じるべきではないと考えています。
第二に、AIコーディング支援の効果自体に懐疑的なデータがあります。研究機関METRが2025年7月に公表したランダム化比較試験は、経験豊富なオープンソース開発者16人に246件の課題を割り当てたところ、AI使用時にむしろ19%遅くなったことを示しています。しかも参加者は事後も「20%速くなった」と誤認しており、体感と実測が逆方向に乖離するという結果でした。ただし同研究は、この結果が「大規模で成熟したリポジトリに精通した熟練者」という特殊な条件下のものであり、初心者や他の開発領域には一般化できないと明確に断っています。
第三に、信頼の低下です。Stack Overflowのプレスリリースは、AI出力の正確性を信頼する開発者が29%(前年40%)まで低下し、最大の不満は45%が挙げた「ほぼ正しいが微妙に間違っている回答」だと報告しています。利用率84%と信頼29%が同時に成立しているわけです。DORAレポートも「AIはチームを直すのではなく、既にあるものを増幅する」とし、プロセスが弱い組織では低品質な成果物が速く量産されるだけだと警告しています。
実務への影響と留意点
税理士・会計事務所にとって、この話は他人事ではないと考えられます。仕訳データの整形、e-Tax・eLTAX向けCSVの加工、顧問先からの資料の集計など、小規模なスクリプトで解決できる業務は多く、AIコーディング支援はプログラマーでない私たちにこそ恩恵が大きい領域でしょう。METR研究が「熟練者×大規模コードベース」の限界を測ったものである以上、逆に「非エンジニア×小さな自動化」では成果が出やすいと私は見ています。そのうえで、留意点を挙げます。
- ベンダー製ランキングを鵜呑みにしない。 会計ソフト選定と同じで、発行元と評価対象の資本関係・利害関係をまず確認し、複数の独立ソースで裏を取るべきです。
- 顧問先データをツールに入れない前提で設計する。 Verdentのガイドもオンプレミス対応やSOC 2認証をTabnineの評価軸に挙げています。守秘義務を負う士業は、コードに顧客の実データを含めない運用と、学習利用の可否・保存場所の確認が最低条件です。
- 「ほぼ正しい」を前提に検証工程を組む。 Stack Overflow調査が示した最大の不満はそのまま税務実務のリスクです。生成したスクリプトは必ずテストデータで検算し、税額計算そのものをAI生成コードに委ねる場合は条文・通達との突合を人間が行うべきです。
- 効果測定を体感でなく記録で行う。 METR研究の「体感と実測の乖離」は、事務所のDX投資判断にも当てはまります。導入前後の処理時間を実測する習慣が有効でしょう。
私の見解
私はAIコーディング支援を日常的に使う立場ですが、今回のVerdentのランキングは「情報としては有用、序列としては割り引いて読む」のが正解だと考えています。皮肉なことに、同ガイド自身の結論である「最良のツールではなく、自分のワークフローに合うツールを選べ」は、利益相反を差し引いてもなお正しい助言でしょう。税理士業界では今後、記帳代行の先にある「業務の内製自動化」でこの種のツールの利用が広がると予想しますが、METRやStack Overflowのデータが示すとおり、効果は使い手と使い方に大きく依存します。ツールの格付けを追いかけるより、小さな定型業務を一つ自動化して実測する――その積み重ねが、2026年の事務所経営における現実的なAI活用だと私は見ています。
出典
- Best AI Coding Assistants 2026: Top 10 Tools Tested & Ranked(Verdent) https://www.verdent.ai/guides/best-ai-coding-assistant-2026
- SWE-bench Verified Report(Verdent Blog) https://www.verdent.ai/blog/swe-bench-verified-report
- Verdent coding agent debuts with 76.1% pass@1 on SWE bench(Testing Catalog) https://www.testingcatalog.com/verdent-coding-agent-debuts-with-76-1-pass-1-on-swe-bench/
- SWE-bench Leaderboard 2026: All Model Scores, Rankings & What They Actually Mean(CodeAnt) https://codeant.ai/blogs/swe-bench-scores
- SWE-bench Verified - AI Benchmark Explained(DemandSphere) https://www.demandsphere.com/research/demandsphere-radar/ai-frontier-model-tracker/benchmarks/swe-bench/
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity(METR) https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- 2025 Stack Overflow Developer Survey: AI https://survey.stackoverflow.co/2025/ai
- Stack Overflow’s 2025 Developer Survey Reveals Trust in AI at an All Time Low(Stack Overflow) https://stackoverflow.co/company/press/archive/stack-overflow-2025-developer-survey/
- DORA | State of AI-assisted Software Development 2025 https://dora.dev/dora-report-2025/
もしこの記事が参考になりましたら、Xアカウント(@ash_ai_tax)もフォローしていただけると嬉しいです。